

AI摘要
MiaoYin
想变声成”独一无二的音色”,或者把某个角色的声线复刻下来?RVC 训练就能做到:喂给模型 10~20 分钟干净的目标音色音频,训练几十分钟就能得到专属 .pth 模型。这篇讲训练全流程和避坑要点。
一、准备训练素材(决定成败的一步)
- 时长:10~20 分钟起步,越多越稳(30 分钟以上更好);
- 质量:干净人声、无伴奏、无混响、无背景噪音;
- 来源:录音、直播回放切片、角色语音包都可以;有伴奏混响的先用 UVR 等工具做人声分离 + 去混响 + 去回声,导出 wav;
- 语速自然、音量统一,删掉长时间静音和爆音片段。
二、训练配置
- 实验名:用英文(中文路径易报错);
- 采样率:选 40k——48k 有较高概率”炸炉”(训练崩坏、出怪声),而且不会更清晰;
- 音高引导:做唱歌模型必须开启,纯语音模型可以不开;
- 版本:无脑选最新版。
三、训练步骤
- 处理数据:自动切片 + 音量归一化,点完确认信息框有输出;
- 提取音高 / 特征:音高用 CPU 提取,特征用 GPU 提取(选卡号);
- 开始训练:默认参数起步,总轮数 200~500 轮常见;训练中可看 TensorBoard 曲线;
- 训练完成在 logs/实验名 目录得到 .pth 和 .index 文件。
四、训练避坑清单
- 炸炉(输出怪叫、金属声):多半是采样率选 48k 或数据太脏,降回 40k、清洗数据;
- 音色不像:素材里有混响/伴奏残留,回到第一步重洗数据;
- 显存不足:减小 batch size,或关闭其他占卡程序;
- 只支持单人训练:素材必须来自同一个人 / 同一个角色。
五、不想自己训练?
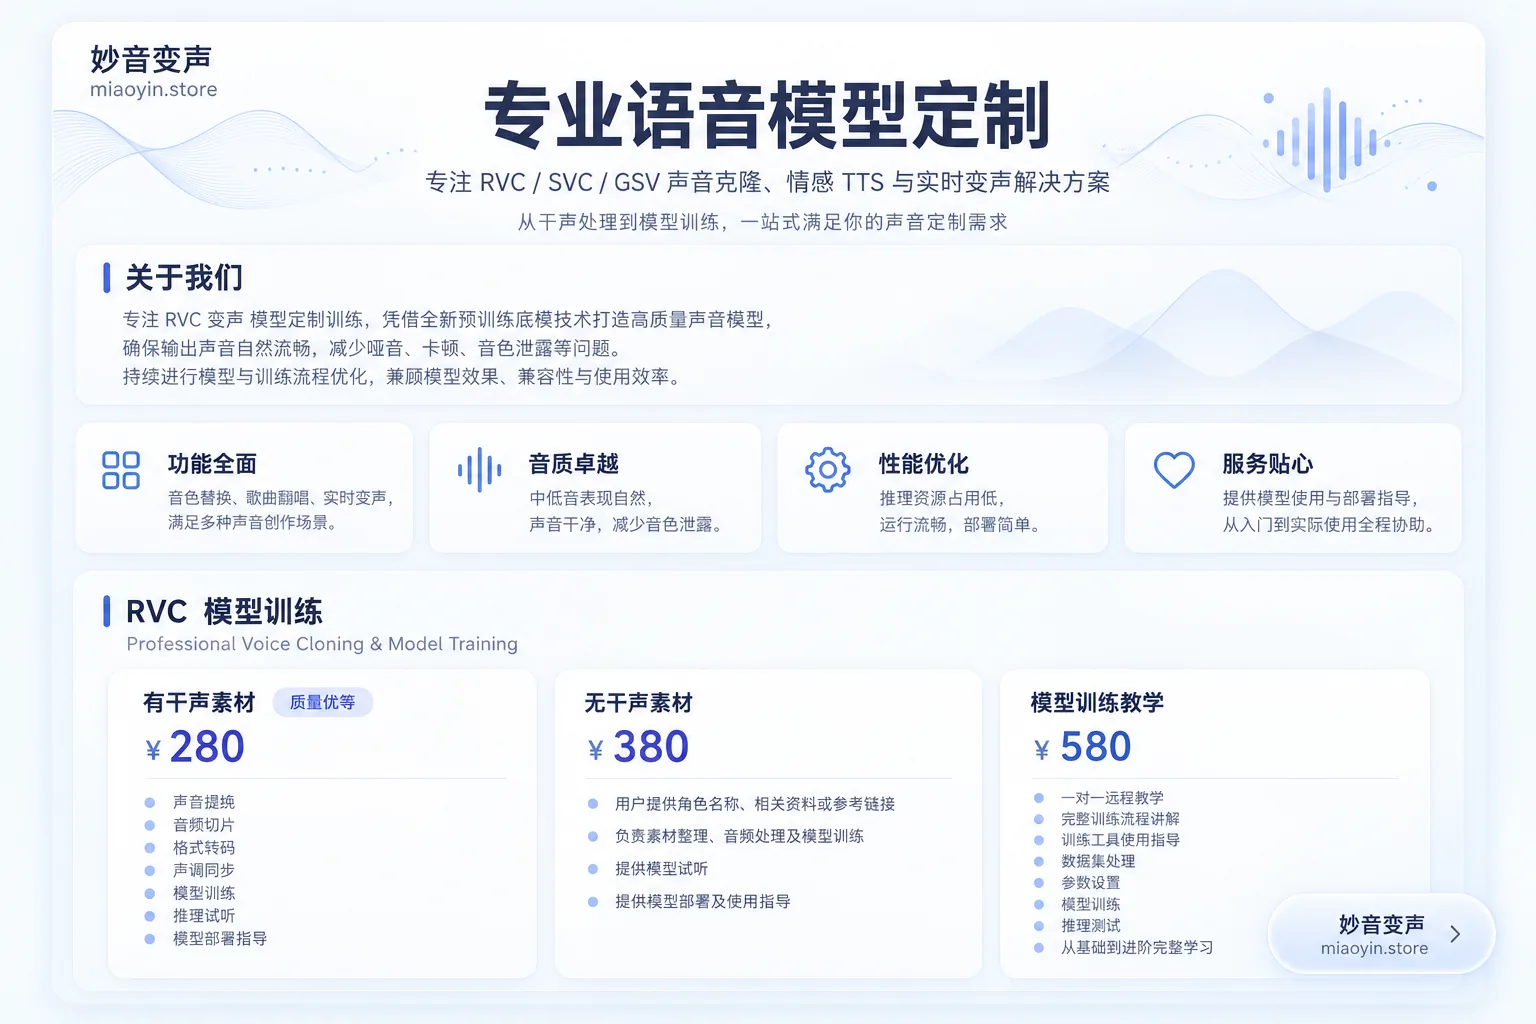
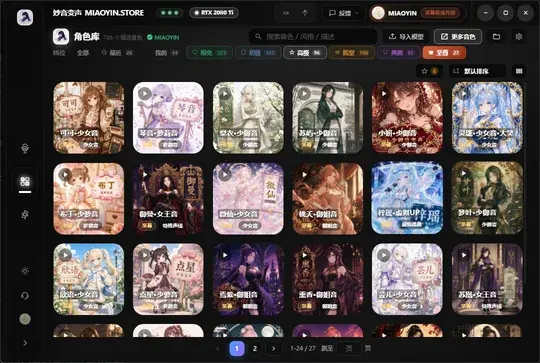
训练要跑几小时、调参也吃经验。如果只想用成品音色,模型库 的 786+ 款音色可以直接下载即用;想要用自己的声音定制专属模型(比如给自己做一套音色矩阵),可以看看 模型定制服务,从数据清洗到训练成品全程代做。
训练出模型后,加载使用方法见 RVC 实时变声教程,参数怎么调见 参数调试详解。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END







 123网盘
 夸克网盘
 百度网盘
 微信扫一扫,添加客服
暂无评论内容