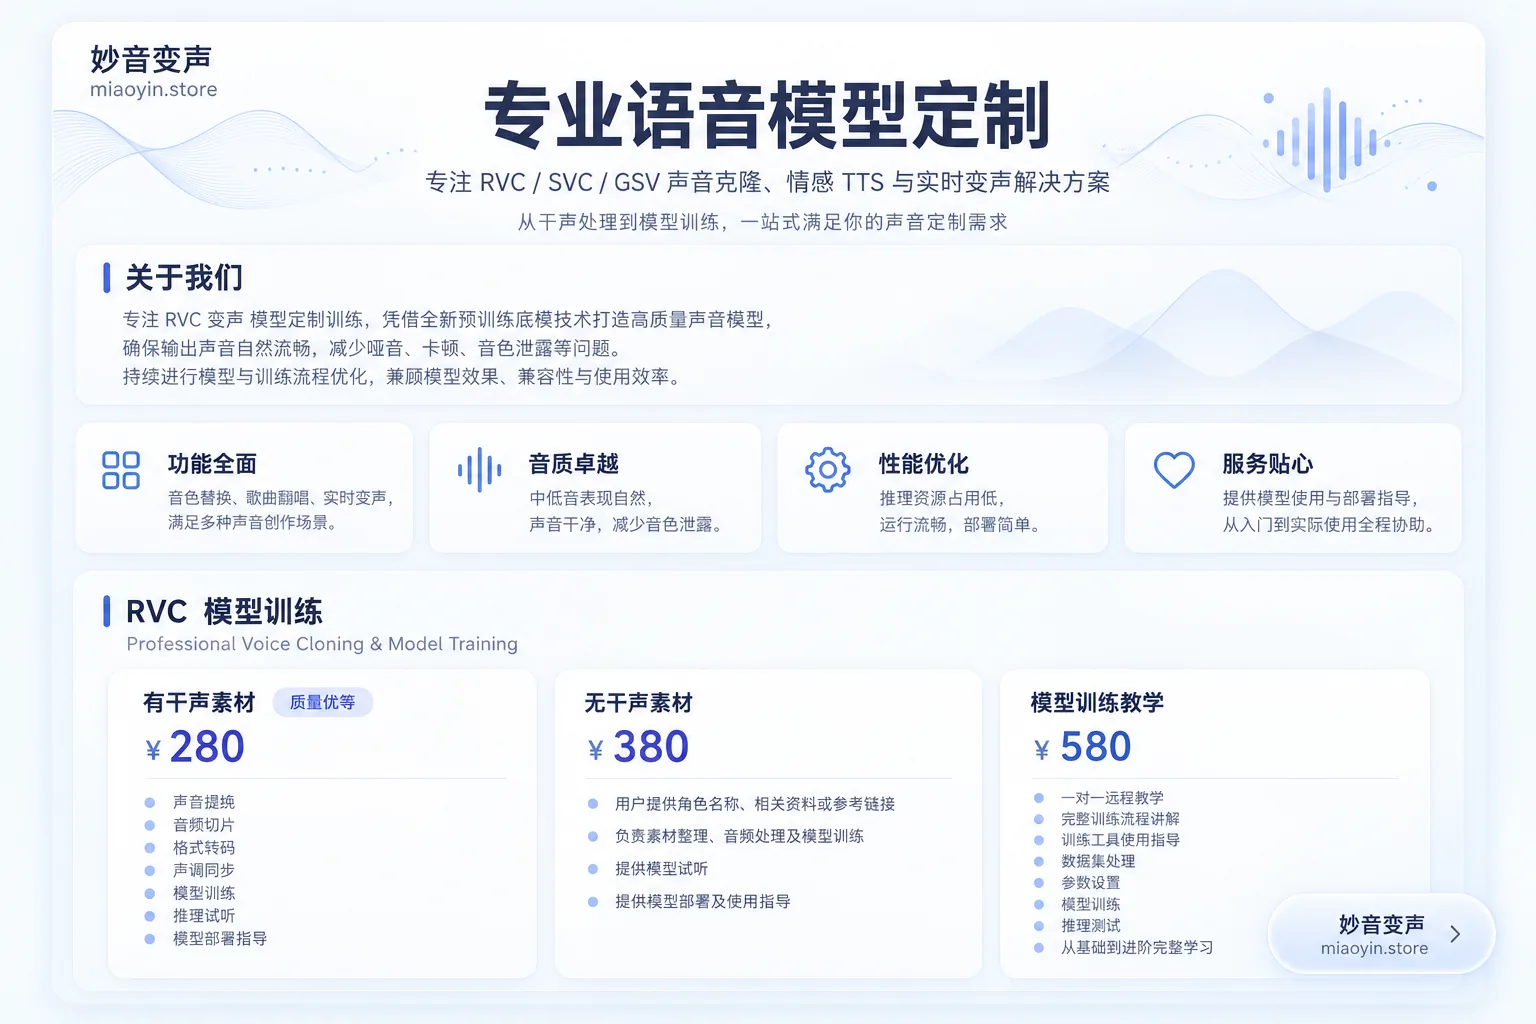
专业语音模型定制
专注 RVC / SVC / GSV 声音克隆、情感 TTS 与实时变声解决方案, 从干声处理到模型训练,一站式满足你的声音定制需求。
01为什么选择我们 WHY US
专注 RVC / SVC 模型定制训练,专业技术打造高质量声音模型,输出自然流畅、无哑音卡喉咙等问题,不同版本模型通用兼容。
功能全面
音色替换、歌曲翻唱、实时变声,覆盖主流语音变换场景,一站式满足创作需求。
音质卓越
中低音合成出众,咬字清晰,无音色泄露,让每一段声音都干净自然。
性能优化
推理资源占用少,运行流畅不卡顿,高效部署,随时随地开启声音创作。
服务贴心
全程指导学习,一站式解决问题,从入门到精通,贴心陪伴每一步。
02RVC / SVC 模型训练 VOICE CLONING
专业声音克隆与模型训练服务,交付即可用于实时变声与 AI 翻唱。
有干声素材
质量优等 · 最快交付¥350/ 次
- 声音提纯、切片、转码、声调同步
- 模型训练、推理试听(免费 2 首或文字试听)
- 模型指导部署学习
无干声素材
全程代办 · 轻松省心¥450/ 次
- 您只需提供角色名、相关信息和角色链接
- 额外包含干声采集与优化流程
- 我们全权负责,直至模型出炉
指导学习训练
一对一远程教学 · 推荐¥650/ 次
- 一对一远程教学
- 涵盖本人所用全部工具
- 从基础到进阶全程指导,轻松掌握核心操作
注:有干声方案要求干声质量优异;无干声方案额外增加采集优化流程。
03GSV 情感 TTS 模型训练 EMOTIONAL TTS
情感文本转语音模型训练,文字直达自然、富有表现力的声音。
有干声数据
标准流程¥400/ 次
- 声音素材优化、切片转码
- 文本标注、模型训练
- 软件部署 + 使用远程教学
有干声数据 · 精细标注
手动精细化标注¥500/ 次
- 声音素材优化、切片转码
- 手动精准文本标注(音频更精准、更富情感)
- 模型训练、软件部署 + 使用远程教学
无干声数据
全包代办¥600/ 次
- 包含上述所有步骤
- 额外提供干声素材收集与优化服务
指导学习训练
一对一到进阶 · 推荐¥1200/ 次
- 一对一远程教学
- 全面讲解模型制作全流程与核心技巧
- 从零构建高情感 TTS 模型
04解疑答惑 FAQ
常见问题与专业解答,让您快速上手。
基础概念
Q1RVC 与 SVC 的区别
RVC 是「轻量级变声、翻唱引擎」,模型内部构建了一个灵动的声音素材库,转换时检索最合适的音色片段巧妙拼接,效率与质量兼顾——模型轻巧、训练飞快,一台普通 4060 笔记本就能驾驭,是当前 AI 翻唱和实时变声领域的主力选手。SVC 是歌声转换的统称,像「专业录音工作室」里的老师傅,对声音细节捕捉非常敏锐,能保留最细微的嗓音特征、气息和情感,但对硬件要求高、处理时间长。推荐新用户选择 RVC(训练快、门槛低),追求极致音质且有高端显卡可选 SVC。
Q2什么是"干声"?为什么训练模型需要干声?
干声(Dry Vocal)是去除伴奏、背景音乐和环境噪音后的人声纯净音频。训练时使用干声可让模型专注学习目标人声的音色特征,避免把伴奏、混响等无关信息混入模型。干声质量越高(无噪音、无混响、清晰度高),训练出的模型音色还原度越好。如果没有干声素材,我们也提供干声提取服务。
Q3什么是"推理"?和训练有什么关系?
训练(Training)是让 AI 学习目标音色的过程——输入大量干声素材,模型反复学习提取音色特征,最终生成专属模型文件。推理(Inference)是使用训练好的模型进行实际应用——将任意音频输入模型,输出替换为目标音色的新音频。简单说:训练是「教会 AI 你的声音」,推理是「让 AI 用你的声音去唱歌/说话」。
Q4什么是歌曲分离(UVR)?
歌曲分离(人声分离、伴奏提取)是将一首完整歌曲拆分为人声和伴奏的技术。常用工具如 UVR5(Ultimate Vocal Remover)利用 AI 模型实现高质量分离。这是 AI 翻唱流程的第一步:先分离提取干声(用于训练或直接推理),再与替换后的干声合并,即可完成一首翻唱作品。
SVC & RVC 实操
Q5需要什么配置才能推理?什么显卡适合训练?
推理仅需 4GB 以上显存的 NVIDIA 显卡即可流畅运行(GTX 1650 及以上)。模型训练建议 RTX 3060 12GB 或更高;显存越大训练越快,也支持更长的音频素材。RTX 4060 Ti 16GB 是目前性价比很高的训练选择。
Q6模型训练需要多长时间?
根据干声时长和显卡性能不同,通常 3~8 小时不等。素材质量越高、时长越充足(建议 15-30 分钟以上)效果越好。训练中软件会实时展示 Loss 曲线,降至稳定值即可停止。
Q7有模型的情况下,翻唱一首歌需要多久?
推理一首 3-4 分钟的歌曲通常只需几秒到十几秒(取决于音频长度与显卡性能)。之后将替换后的干声与伴奏合并,一首完整的 AI 翻唱作品就完成了。
Q8学习整体流程需要多长时间?
一对一指导通常 1-2 小时即可掌握基础流程:干声准备与预处理、训练参数设置、推理操作与调参、后期混音合并。后续遇到问题可随时咨询,我们持续提供技术支持。
Q9训练模型需要多少音频素材?
建议提供 15-30 分钟的清晰干声,覆盖不同音高和情感表达(说话、正常音区、高音区等),模型在各种场景下表现才稳定。时长越长、音质越高,效果越好。
Q10RVC 模型支持实时变声吗?
支持。使用 w-okada 等开源变声器加载 RVC 模型即可实现低延迟实时变声,适用于语音通话、游戏开麦、直播等场景。延迟通常 100-300ms(取决于硬件),咬字清晰,日常使用流畅自然。
GSV 相关
Q11GSV 和 RVC 有什么区别?
RVC 是声音转换模型,需要输入一段已有音频替换音色(音色对音色);GSV 是文本转语音(TTS)模型,输入文字即可生成目标音色的语音(文字对音色)。RVC 适合翻唱和实时变声,GSV 适合有声书配音、虚拟主播对话等场景。
Q12GSV 能实现情感控制吗?
可以。GSV 支持通过标注数据实现情感语音合成——训练时在文本标注中加入情感标签(开心、悲伤、愤怒、温柔等),推理时选择对应情感参数即可生成带不同情感色彩的语音,效果非常自然。
Q13GSV 推理和训练的显卡要求?
推理与 RVC 类似,4GB 显存即可。训练建议 RTX 3060 12GB 或以上;GSV 模型结构比 RVC 更复杂,显存需求略高,推荐 RTX 4060 Ti 16GB 或更高配置。
Q14支持 A 卡、I 卡、MAC 电脑吗?
目前主要支持 NVIDIA 显卡(CUDA 加速),性能最优。AMD / Intel 显卡可通过 ONNX Runtime 推理但速度较慢;MAC(Apple Silicon M 系列)可通过 MPS 加速获得一定性能提升,训练效率仍不及同价位 N 卡。
其他常见问题
Q15AI 翻唱的完整流程是什么?
共六步:1. 收集目标角色干声素材 → 2. 音频预处理(降噪、切片、转码) → 3. 模型训练 → 4. 推理测试 → 5. 导入目标歌曲并用歌曲分离提取伴奏和原唱干声 → 6. 模型推理替换原唱干声,合并伴奏输出成品。
Q16模型可以商用吗?有没有版权问题?
训练出的模型仅供个人学习和娱乐使用。若需用于商业项目(广告配音、游戏角色语音、虚拟偶像等),请确保已获得目标音色素材的合法授权。翻唱作品发布到公开平台时,也需注意原曲版权许可。
Q1748kHz 和 40kHz 模型有什么区别?
48kHz 采样率更高,能捕捉更丰富的高频细节,音质更通透饱满,适合音乐制作、专业翻唱等高要求场景;40kHz 体积更小、推理略快,日常使用已经很好。主流趋势是 48kHz,我们默认训练 48kHz 高音质模型。
05联系我们 CONTACT
开启你的专属声音
专业、高效 · 一对一技术支持与模型定制,如有任何疑问或定制需求,欢迎随时咨询。
唯一官方入口 miaoyin.store(谨防仿冒)
定制咨询 VIP 用户专属 QQ 群 · 一对一对接
响应时间 全天咨询 · 尽快回复
妙音变声 · 定制服务 | 定制模型仅供学习与个人娱乐使用,商用请确保已获得音色素材合法授权。


 123网盘
 夸克网盘
 百度网盘
 微信扫一扫,添加客服